被忽略的那块拼图:语言大模型赢在“天然语料库”
过去几年,人工智能行业发生了一件值得所有人停下来想一想的事:大语言模型被广泛应用,算力基础设施以前所未有的速度扩张,OpenAI、Anthropic 这样的企业在短短几年里长成了万亿美元估值的巨头,国内DeepSeek、智谱等公司估值几千亿人民币。但在一片喧嚣中,一个更本质的问题很少有人正面回答——大语言模型凭什么能成?
“大语言模型之所以能成功,不只是因为有算法,更是因为人类恰好拥有一个记录所有知识的标准化语料库 - 互联网上的文本,用于训练大模型。”在9月28日于西湖大学召开的一场“新一代人工智能”国家科技重大专项启动会上,西湖大学创校副校长、讲席教授许田把这句话抛给了在场所有人。他反复强调,这一点其实被很多人忽略了,而它恰恰是理解今天全部工作的关键。
大语言模型有标准化的海量语料,而生命科学没有。生命活动的基因表达组学、蛋白组学、代谢组学、宏基因组学…… 这些数据的产生方式不同,实验平台不同、质控标准不同、批次和环境影响不同…。它们像说着几十种方言的碎片,散落在不同的实验室和数据库里。没有高质量、统一的 "生命活动数据",无从训练生命语言的通用大模型。
正是在这样的背景下,科技部2026年新一代人工智能国家科技重大专项“生命科学多组学数据智能治理工具流与标准化数据集的构建”项目正式启动。这不仅是一个科研项目的开端,更释放出一个明确的信号:中国AI生物医药正在从“拼专业模型”的上半场,进入“拼数据基建”的下半场。
第二波AI为什么属于生物医药
在许田教授看来“第一波AI浪潮属于语言。第二波属于生命的AI浪潮正在到来。”这个判断并非空想,而是正在发生的转向:诺奖获得者Demis Hassabis 离开DeepMind,创建Isomorphic Labs;另一位诺奖获得者David Baker 和斯坦福前校长一起创建Xaira Therapeutics;Anthropic、字节跳动等大模型公司,正在把他们的模型能力投向生命科学。
“当语言和知识的问题被大模型解决之后,下一个真正意义上‘通用’的问题,就是生命本身。”许田说,但做生命科学的人都清楚,这里有一个绕不过去的坎——生物医药到今天为止,还没有一个通用大模型。我们有的,只是一个个专业型模型,各管一段、互不相通。
为什么会这样?答案不在算法,而在数据。大语言模型有标准化的语料,而生命科学没有。“瓶颈,卡在数据标准化。而这,正是我们这个专项要去做的事。”许田说。
DeepAdapter:给异构组学数据装一个“深度适配器”
长期以来,生命科学领域的数据治理更像是一门“手艺活”。面对极其复杂的多组学数据,科研人员往往需要耗费大量精力进行人工清洗、对齐和标注。这种高度依赖人工、缺乏标准化的模式,不仅效率低下,更难以支撑大模型时代对高质量数据的指数级需求。
此次国家重大专项的核心目标直指这一痛点。项目由西湖大学许田教授团队牵头,杨东研究员任项目负责人,试图构建一套覆盖“数据解析、清洗、增强、数据集构建与产业化应用”的全链条AI基础设施平台。通俗来说,就是要将数据治理从“手工作坊”升级为“自动化流水线”。
承载这一目标的,是西湖大学许田教授团队提出的一条名为 DeepAdapter 的技术路线,该技术论文以封面文章刊登在2026年3月该领域国际顶级期刊Nature Biomedical Engineering。它的本质,是给异构的组学数据装上一个“深度适配器”——把来自不同平台、不同批次、不同实验室的基因表达组学、蛋白组学、代谢组学、宏基因组学等数据,映射、对齐、标准化到一个统一的坐标系里。“我们在做的事情,是为生命科学造一套‘普通话’,让散落的数据说同一种语言。”许田教授如此概括。
通过标准化的工具链,杂乱无章的原始数据将经过AI解析与清洗、数据增强与质量管理,最终转化为可供大模型直接“消化”的标准数据集,为全球生物医药领域提供一个标准的生命“百科全书”,用于训练生命语言大模型等应用。
产学研“铁三角”:让数据在真实场景中闭环
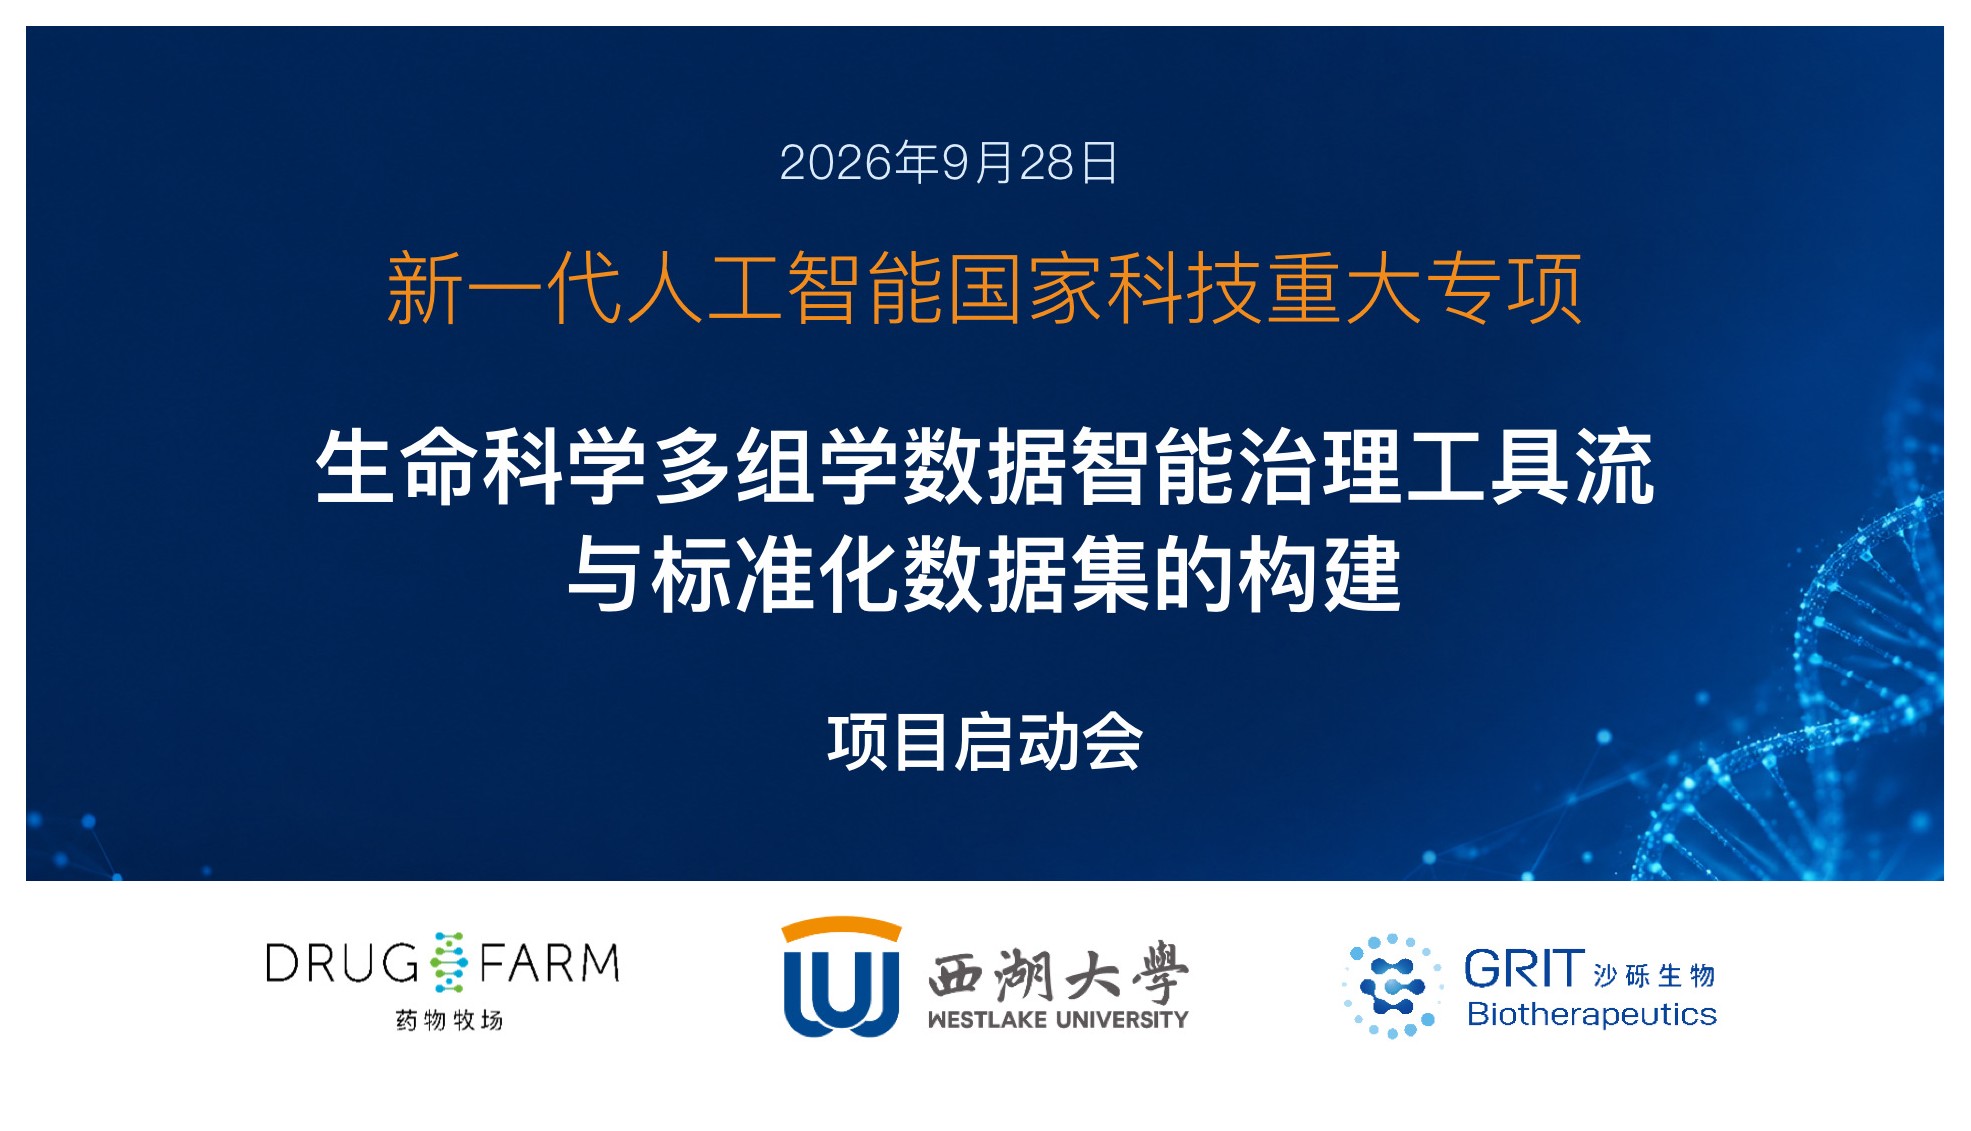
在国家科技重大专项的布局中,产学研的协同往往决定了项目的最终落地效果。本次项目组建了一个极具代表性的“铁三角”阵容:西湖大学、沙砾生物和药物牧场三方的组合,恰好覆盖了从基础研究到产业应用的完整闭环。
“这个项目的结构很清楚:西湖大学做方法和数据,产业方做落地应用,中间是模型。” 沙砾生物创始人和CEO刘雅容博士和药物牧场共同创始人和CSO许枞博士评价道。具体而言,西湖大学作为新型研究型大学,提供 DeepAdapter 方法与基础研究的原始创新支撑;沙砾生物作为专注于细胞治疗与精准医学的高新技术企业,能为工具链提供真实的药物研发场景和临床数据;药物牧场则发挥其从新靶点发现到临床转化的完整研发体系和知识图谱优势,负责把工具链落地并验证标准数据集的有效性。
而这套标准化数据,并不会只停留在学术论文里。有了标准化数据,下一步水到渠成——训练生命语言大模型,并立刻在两个方向落地:一是药物牧场,用它做靶点发现,从海量对齐后的组学数据里读出生病与健康之间的差异,结合PB转座子活体靶点发现平台,快速找出真正值得成药的关键靶点;二是沙砾生物,用它做新疫苗的靶点发现,在肿瘤新抗原和疫苗方向上筛选真正有效的免疫靶点。
争夺全球话语权:数据标准即科学话语权
放眼全球,AI制药的竞争早已超越了单一企业的范畴,演变为国家层面的数据基础设施之争。谁掌握了高质量的标准数据集,谁就掌握了定义行业规则的权力。此次国家科技重大专项的启动,正是中国在这一领域争夺话语权的关键落子。项目不仅着眼于解决当下的数据治理难题,更将“标准体系建设”作为核心目标之一。正如项目负责人杨东在启动会上所言,期待形成具有自主知识产权的数据治理工具链,提升我国在全球AI数据基础设施领域的竞争力。
“数据标准,本质上就是科学话语权。”许田教授对这一点的分量看得极重。在科技部支持下,通过这个“下一代人工智能”国家科技重大专项,团队要用 DeepAdapter 生产一套中国标准、覆盖全组学的高质量数据。在他看来,这件事的长期意义在于:今天把标准做好,未来中国的生物数据就有能力实现全球化,成为全世界都可以依赖的基础设施。通过推动我国科学数据治理的标准规范制定,提升数据的互操作性和复用价值,中国正在试图从全球AI生物医药的“跟跑者”,转变为标准的“制定者”。
我们做研究的人,常常被问一个问题:这个东西有什么用?今天我们这个专项,或许能给出一个回答 ——当数据的语言被统一之后,生物医药这门学科,第一次有机会像信息科学那样,进入一个可以被 "计算" 的时代,让人工智能变成解决生老病死的绿色智能。
当聚光灯从大模型本身移开,照亮那些默默支撑模型训练和运转的数据基建时,我们或许才能真正看清AI生物医药的未来。这场关于“数据”的攻坚战,才刚刚开始。
沙砾生物是一家创新驱动型、处于临床后期阶段的生物制药公司,专注于为全球癌症及自身免疫性疾病患者开创下一代免疫疗法,在免疫治疗领域拥有深厚的技术平台积累和产业化经验。公司建立了从靶点发现、候选药物筛选到临床转化的完整研发体系,积累了大量的多组学临床数据。在本项目中,沙砾生物将重点承担多组学数据集在创新药物研发场景中的产业化应用验证,例如新抗原发现和肿瘤疫苗开发,推动数据工具链与药物研发流程的深度融合。
药物牧场是一家聚焦生物医药数据智能与AI药物研发的科技企业,在医药知识图谱、临床数据治理、智能药物设计等方面具有领先的技术优势。公司致力于用AI技术重构药物研发全流程,已建立覆盖靶点识别、分子设计、临床预测等多环节的数据平台。在本项目中,药苑生物将发挥其在数据治理与AI应用方面的工程化能力,参与标准数据集的建设与工具链的落地验证,助力实现数据驱动的药物研发范式变革。

 渝公网安备 50011202502165号