过去几年,人工智能(AI)在药物研发中的角色正在发生变化。
如果说早期的AI制药更多是在单个环节提升效率,例如预测蛋白结构、筛选化合物或寻找潜在靶点,那么新一轮竞争开始指向更大的目标——让AI不仅“看懂”生物数据,还能够预测细胞在受到药物、基因或环境变化后会发生什么。
“Virtual Cell(虚拟细胞)”正是在这一背景下成为新的研究热点。
但对Recursion Pharmaceuticals(下文简称“Recursion”)而言,Virtual Cell并不是突然出现的新概念。
2013年成立时,Recursion就从自动化细胞实验和计算方法入手,试图将原本依赖人工观察的细胞生物学转化为规模化数据。
十余年后,这家公司已经将能力扩展至表型组学、转录组学、计算化学、临床数据和AI模型,并积累超过50PB专有数据,每周最多开展约200万次实验。
如今,Recursion开始在这套体系之上推进Virtual Cell。
从三个人开始,Recursion押注“让计算机观察细胞”
Recursion的故事始于2013年。
公司由Chris Gibson、Blake Borgeson和Dean Li共同创立。三位创始人的背景横跨医学、生物学与计算领域,这也成为Recursion最初技术路线的基础。
Recursion早期想验证的,是一个看似简单、但在当时并不容易回答的问题:如果把细胞变化转化为可以被计算机识别的数据,机器能否从中发现人类研究者容易遗漏的生物学规律?
这一想法与传统药物研发的工作方式存在明显差异。
传统药物发现往往从疾病机制、靶点或已有生物学知识出发,研究人员提出假设后,再通过实验逐步验证。但细胞并不是由单一靶点决定的简单系统。一个基因或化合物发生变化,可能同时影响细胞形态、基因表达、代谢以及其他生物过程。如果研究始终围绕少数预设靶点展开,就可能难以系统捕捉这些复杂的关联。
Recursion选择表型药物发现(phenotypic drug discovery)作为切入口。
简单来说,与其先确定一个靶点、再寻找能够作用于它的化合物,Recursion更强调先观察细胞“发生了什么”。公司利用自动化实验对细胞施加基因或化学扰动,再通过高内涵成像获得大量细胞图像,最后借助计算机视觉和机器学习识别其中的表型变化。
这种方法的关键,不只是一次实验能够产生多少张图片,而是能否让实验持续产生结构化数据,并让计算模型从数据中发现新的模式。
随着实验规模扩大,原本依赖研究人员观察和判断的细胞表型,开始被转化为可以计算、比较和训练模型的数据。
这条路线很快开始接受药物研发本身的检验。
2015年,Recursion获得美国食品药品监督管理局(FDA)的首个孤儿药认定;2018年,公司首个候选药物的研究性新药(IND)申请获批并启动临床试验。对于一家从细胞表型和自动化实验起步的公司而言,这两个节点意味着最初的技术探索已经开始向真正的药物研发项目延伸。
与此同时,资本也在持续进入。
Recursion先后完成多轮股权融资,2020年完成2.39亿美元D轮融资,由Bayer旗下Leaps by Bayer领投;到2021年IPO之前,公司累计获得约4.489亿美元股权融资,另获得Bayer合作的3000万美元首付款。2021年4月,Recursion登陆纳斯达克,IPO募集资金约5.018亿美元。
资本市场给Recursion带来的,不只是资金规模的变化,也让公司能够继续扩大实验、计算和药物研发投入。这也奠定了Recursion此后十余年的发展方向:让实验产生数据,让数据训练模型,再让模型指导新的实验。
一套Recursion OS,连接生物学、化学与临床
Recursion如今真正的核心,并不是某一个AI模型,而是一套名为Recursion OS的端到端药物研发平台。
简单来说,这套系统试图把药物研发拆解为三个相互连接的环节:从生物学数据中发现规律,从规律中寻找和设计分子,再将候选药物推进临床。
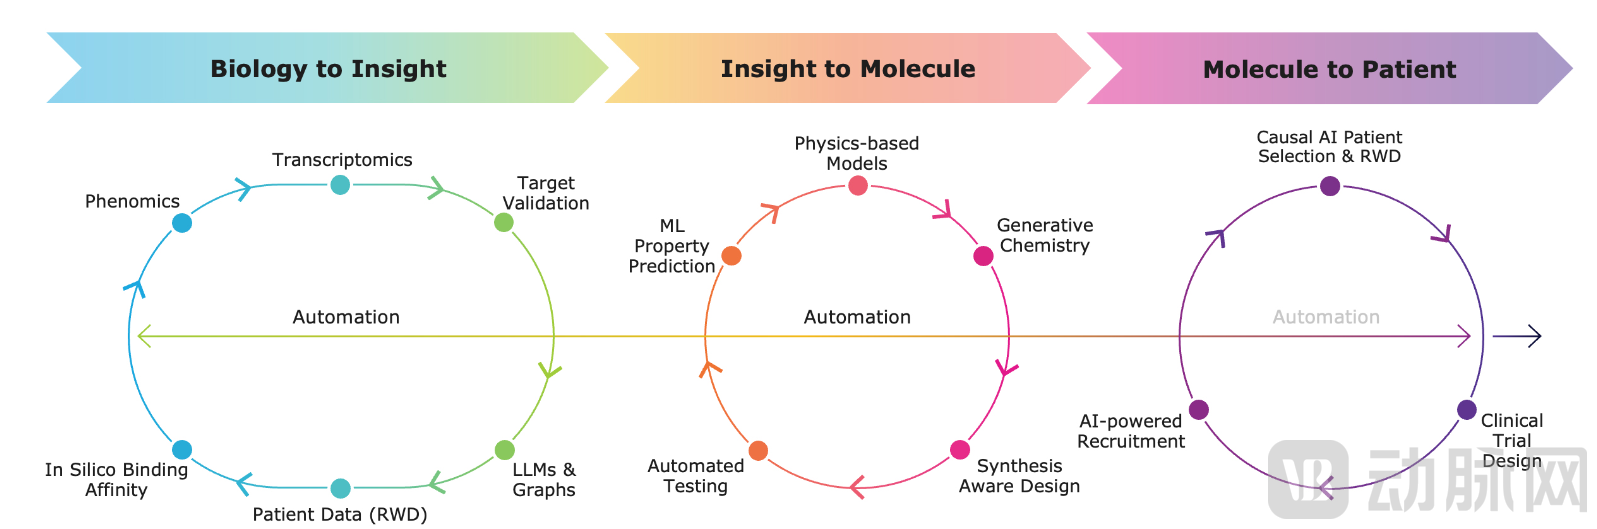
第一步,是Recursion最早建立的表型组学能力。
传统药物发现往往围绕预先确定的靶点展开,需要研究人员先提出机制假设,再通过实验验证。但细胞是复杂的生物系统,单一靶点或单一指标很难完整描述药物干预后的变化。
Recursion选择从细胞表型入手。公司利用CRISPR(Clustered Regularly Interspaced Short Palindromic Repeats,成簇规律间隔短回文重复序列)等基因扰动工具以及化合物处理细胞,再通过高内涵成像(HCI)记录大量细胞形态变化,并利用机器学习寻找不同基因、化合物与细胞状态之间的关联。
第二步,是从生物学洞察走向分子设计。
随着2024年完成对Exscientia的收购,Recursion进一步补充了计算化学能力。如今,公司可以将生物学模型发现的潜在靶点与化合物生成、分子性质预测和蛋白质—配体结构分析连接起来。其中,Boltz-2由Recursion与MIT团队共同开发,用于同时预测蛋白质—配体结构和结合亲和力;公司披露,其在相关基准测试中的速度最高可达到传统方法的约1000倍。
第三步,则是向临床研发延伸。
Recursion通过Tempus等合作获得患者数据,并发展临床开发工具,用于患者分层、生物标志物和临床研究等环节。与此同时,公司推出LOWE,即LLM-Orchestrated Workflow Engine,通过大语言模型(LLM)调度药物发现工作流,将生物学分析、化合物设计和实验流程进一步连接起来。
三者连接起来,形成的并不是一串独立工具,而是一个持续循环的系统:实验产生数据,数据进入模型,模型产生新的生物学假设和分子设计,再由实验进行验证。
这套“实验—数据—模型—再实验”的闭环,也是Recursion进一步推进Virtual Cell的基础。
AI最终仍要回到“能不能做成药”
对于AI制药公司而言,平台能力最终仍要落到真实管线上。
目前,Recursion的研发重点集中在肿瘤和罕见病领域,管线包括REC-1245、REC-4881,以及CDK7、MALT1、LSD1等多个方向。2026年,公司还披露PI3Kα H1047R抑制剂REC-7735已获美国FDA许可启动临床研究。
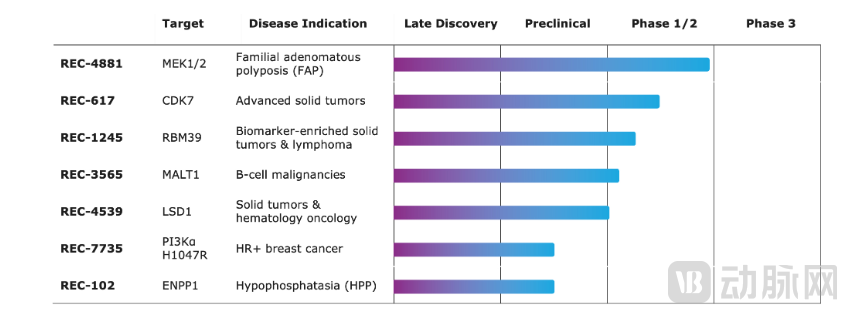
其中,REC-1245体现了Recursion在研发效率上的探索。
REC-1245是一款针对RBM39的分子胶降解剂,面向生物标志物富集的实体瘤和淋巴瘤。公司披露,该项目从靶点识别到IND申报前研究耗时不到18个月,期间合成约200个化合物。2024年12月,该项目完成首例患者给药,目前仍处于早期临床阶段。
REC-4881则提供了更直接的临床验证案例。这是一款MEK1/2抑制剂,用于治疗家族性腺瘤性息肉病(FAP)。
在TUPELO研究中,每日4mg治疗13周后,患者息肉负荷中位数下降43%;停药12周后,第25周中位降幅达到53%,82%的患者仍维持息肉负荷下降。公司随后与美国FDA就后续注册路径展开沟通,并已获得快速通道和孤儿药资格。
REC-1245和REC-4881承担的意义并不完全相同:前者体现从生物学发现到候选药物推进的效率,后者则进一步检验这套研发路径能否产生临床疗效信号。
换句话说,Recursion真正需要证明的并不是AI能够替代传统药物研发,而是这套“数据—模型—实验—管线”的闭环,能否持续转化为临床资产。
大药企正在验证Recursion什么?
如果只看自己的研发管线,很难完整理解Recursion在AI制药行业中的位置。
更值得观察的,是它已经形成的一张合作网络——一端连接Roche/Genentech、Bayer、Sanofi等大型药企,另一端则连接NVIDIA、Google Cloud、Tempus、Helix等技术和数据伙伴。
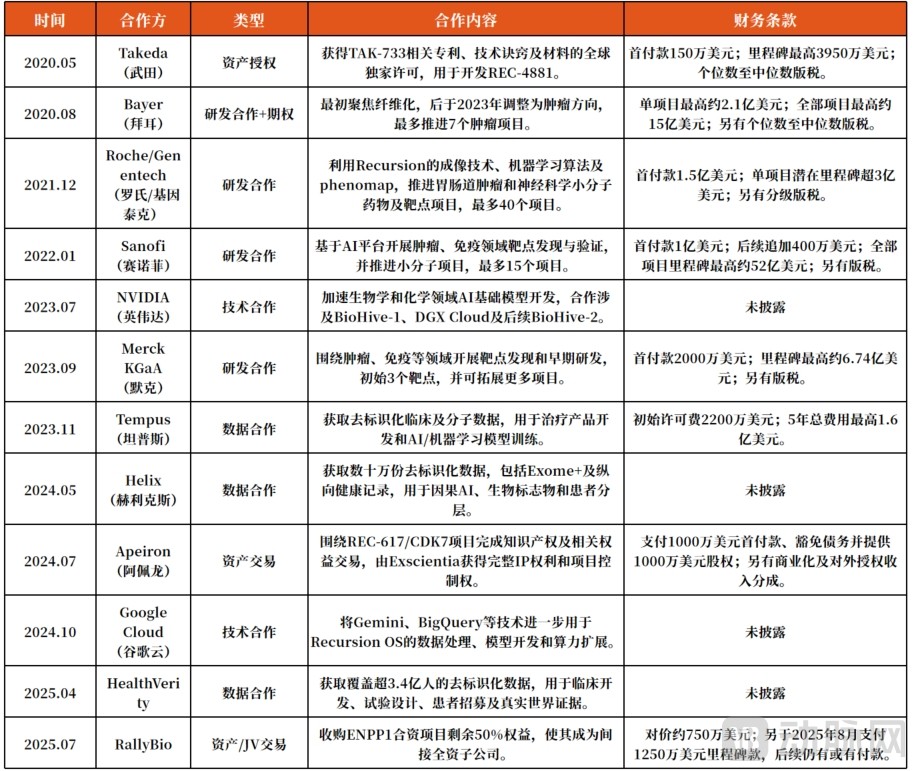
Recursion主要合作与交易时间线
2021年,Recursion与Roche旗下Genentech启动战略合作,聚焦神经科学和胃肠道肿瘤,合作最多可覆盖40个项目。Recursion获得1.5亿美元首付款,并可根据项目进展获得里程碑付款及分层特许权使用费。
2026年8月,Genentech将双方合作发现的首个神经科学靶点推进至联合小分子早期研发项目。此前,该靶点已经经过通路、人源神经元功能及疾病模型等多层验证。
Bayer和Sanofi同样与Recursion建立了大规模合作。Recursion与Bayer的合作后来延伸至精准肿瘤学,计划推进最多7个项目,潜在里程碑付款最高约15亿美元;Bayer还曾成为Recursion LOWE的首个外部Beta用户。
与Sanofi的合作则聚焦肿瘤和免疫领域,最初计划探索最多15个新靶点,协议包含1亿美元首付款及最高52亿美元潜在里程碑付款。截至2026年,Recursion披露已从该合作获得1.34亿美元首付款及里程碑付款。
如果说这些药企合作验证的是“AI能不能产生药物研发资产”,那么NVIDIA、Tempus和Google Cloud等合作验证的,则是Recursion另一层能力——能不能把这套研发系统持续扩张。
2023年,NVIDIA向Recursion投资5000万美元,并与其建立多年战略合作。双方计划利用NVIDIA的计算能力和Recursion的大规模生物、化学数据训练基础模型;NVIDIA还为Recursion提供DGX Cloud等计算资源,并探索通过BioNeMo平台分发Recursion的模型。
双方的合作随后进一步落到基础设施。Recursion与NVIDIA共同建设BioHive-2,由63套DGX H100系统、504块H100 GPU组成,用于支撑生物学和化学基础模型训练。2025年发布的Boltz-2,也使用了由NVIDIA加速的BioHive-2进行开发。
数据端则由Tempus和Helix补上。
2023年,Recursion与Tempus达成5年数据合作,以最高约1.6亿美元的总对价持续获得患者中心的肿瘤多模态数据;2024年,公司又与Helix合作,获得数十万份去标识化、非肿瘤患者的纵向临床记录及基因组数据。
Google Cloud则在2024年扩大与Recursion的合作,双方探索利用Gemini等生成式AI能力支持Recursion OS,同时通过BigQuery改善数据搜索和访问,并扩展计算资源。
把这些合作放在一起看,Recursion的商业模式就更加清晰了。
药企提供疾病领域知识、化合物资源和临床开发能力,数据伙伴提供患者层面的真实世界数据,NVIDIA和Google Cloud等技术伙伴提供计算与AI基础设施,而Recursion试图把这些资源统一纳入自己的研发系统。
因此,大药企真正验证的并不是Recursion某一个AI模型的准确率,而是一个更大的命题:
一套以数据和AI为核心的研发系统,能否持续发现新的生物学关系,并最终转化为药物资产?
截至目前,Recursion已经拿到了部分答案——合作伙伴已经为地图、靶点和项目持续付费,也已经有项目从计算发现走向药物研发。
但这仍不是终点。
因为对Recursion而言,合作越多、数据越大、模型越复杂,最终都要回到同一个问题:这些能力能否持续转化为临床阶段的高价值药物。
从AI制药到虚拟细胞,Recursion下一步要做什么?
走到今天,Virtual Cell并不是Recursion突然选择的新方向。
回看这家公司十余年的发展,路径其实十分清晰:最初解决的是如何规模化观察细胞;随后是如何把观察结果变成数据;再往后是如何从数据中发现生物学关系、设计候选药物并进入临床。
如今,问题进一步变成:
如果已经积累了足够多的细胞扰动数据,AI能否在计算机中预测下一次实验会发生什么?
这正是Virtual Cell与Recursion过去十余年积累之间的连接点。Virtual Cell更像是Recursion现有研发体系向前延伸的一层能力,而不是一次新的战略转向。
这也意味着,判断Recursion下一阶段成败的标准,最终仍然不会是模型有多大、数据有多少,而是这些能力能否继续向药物研发结果传导。
过去十余年,Recursion已经证明自己可以规模化产生数据、训练模型,并将部分模型输出转化为靶点和候选药物;下一阶段,它需要进一步证明的是,这套体系能否稳定地产生更高质量的临床资产,并形成可持续的商业回报。
对于正在探索Virtual Cell的国内企业而言,这或许是Recursion更值得参考的地方:真正的壁垒不只是模型,而是持续产生高质量数据、让模型反过来指导实验,并最终进入真实药物研发流程的能力。
从“让机器看懂细胞”,到尝试“让AI预测细胞”,Recursion已经走了十余年。
而Virtual Cell真正需要回答的问题,也最终会回到药物研发最现实的终点:
当AI开始预测细胞,它能不能真的帮助人类发现更好的药物?

 渝公网安备 50011202502165号