上世纪,科学哲学家波普尔在《科学发现的逻辑》中提出,科学进步并非源于正确答案的积累,而是通过“猜想与反驳”的循环实现。即科学家提出大胆假说,再通过严格证伪这些假说,从而推动科学知识的增长。
多年过去,这句话非但没过时,反而精准戳中了当下 AI4S尴尬的地方:会“猜想”的越来越多,能“反驳”、能验证的却越来越稀缺。
过去几年,AlphaFold几乎重新定义了结构预测的天花板,生成式模型把分子、蛋白、核酸的设计效率抬高了几个数量级,一级市场的钱也顺着算力+管线的故事蜂拥而入。可热闹归热闹,一个底层矛盾始终没有解决:模型一晚上能吐出成千上万个候选分子,湿实验却卡在材料、人力和周期上,只能一个个慢慢做。上游的预测堆积与下游的验证瓶颈之间,剪刀差越拉越大。
科理新序(Scinetics)首席运营官Erik把行业痛点说得很直白:“AI可以一口气生成一万个蛋白序列,可如果它们都跑不出想要的功能,算力烧得再多也变不出科学价值;反过来,哪怕只有一两个真正被实验验证有效的发现,产业价值就足够惊人。”
面对行业痛点,成立于2026年8月的科理新序,选择从最底层,也最难啃的地方切入。这家刚成立的AI4S公司,既没在通用大模型上做个垂直微调,也没止步于打磨某一件单点工具,而是提出了一整套涵盖科学原生表征、推理范式与迭代路径的完整框架,并同步对外发布系列技术报告,试图从根源上重构AI与科学发现的相处方式。
团队由两位兼具学术与产业视野的年轻创始人领衔:CEO兼CTO张载熙生于1998年,曾就读于中科大少年班,获中科大计算机博士学位,先后在哈佛医学院、普林斯顿开展研究,于2026年夏入职港科大担任助理教授。联合创始人兼COO Erik生于2002年,本科毕业于康奈尔大学,也在密歇根大学、普林斯顿有过研究经历,曾在再生元制药担任过自动化工程师,本科创业项目曾获美国校园基金投资。
当语言模型讲不清一个酶,那就给科学单独造一套“词”
要理解科理新序为什么要绕开主流路线,得先看一个反复上演的“翻车”现场。
Erik描述,让大语言模型优化一个蛋白时,模型会报告“已经优化了三轮、五轮”,但科学结果并未改善,甚至更差。问题不在它“话”说得好不好,而在于它的整个推理都困在文字里,而生命科学的关键推理,压根不发生在文字之间。
把纯文本思维链硬搬到酶设计上,会撞上三堵墙:其一,三维结构、键角、空间位阻这些东西,文字根本说不清;其二,文本上逻辑自洽,不等于物理和生物学上可行;其三,推理过程缺少一个可直接检验、可修正的科学状态,每一步都停留在形容词里。
科理新序递出的第一把钥匙,叫Science Token。说白了,就是把蛋白质或核酸序列、局部三维几何、显微图像、组学状态,以及带单位和实验条件的测量值,统统拆成一个个“原生单元”,和文字共用同一个模型来读和写。模型不必先把结构翻译成文字再思考,而是能直接在科学对象自己的表征空间里动手操作。
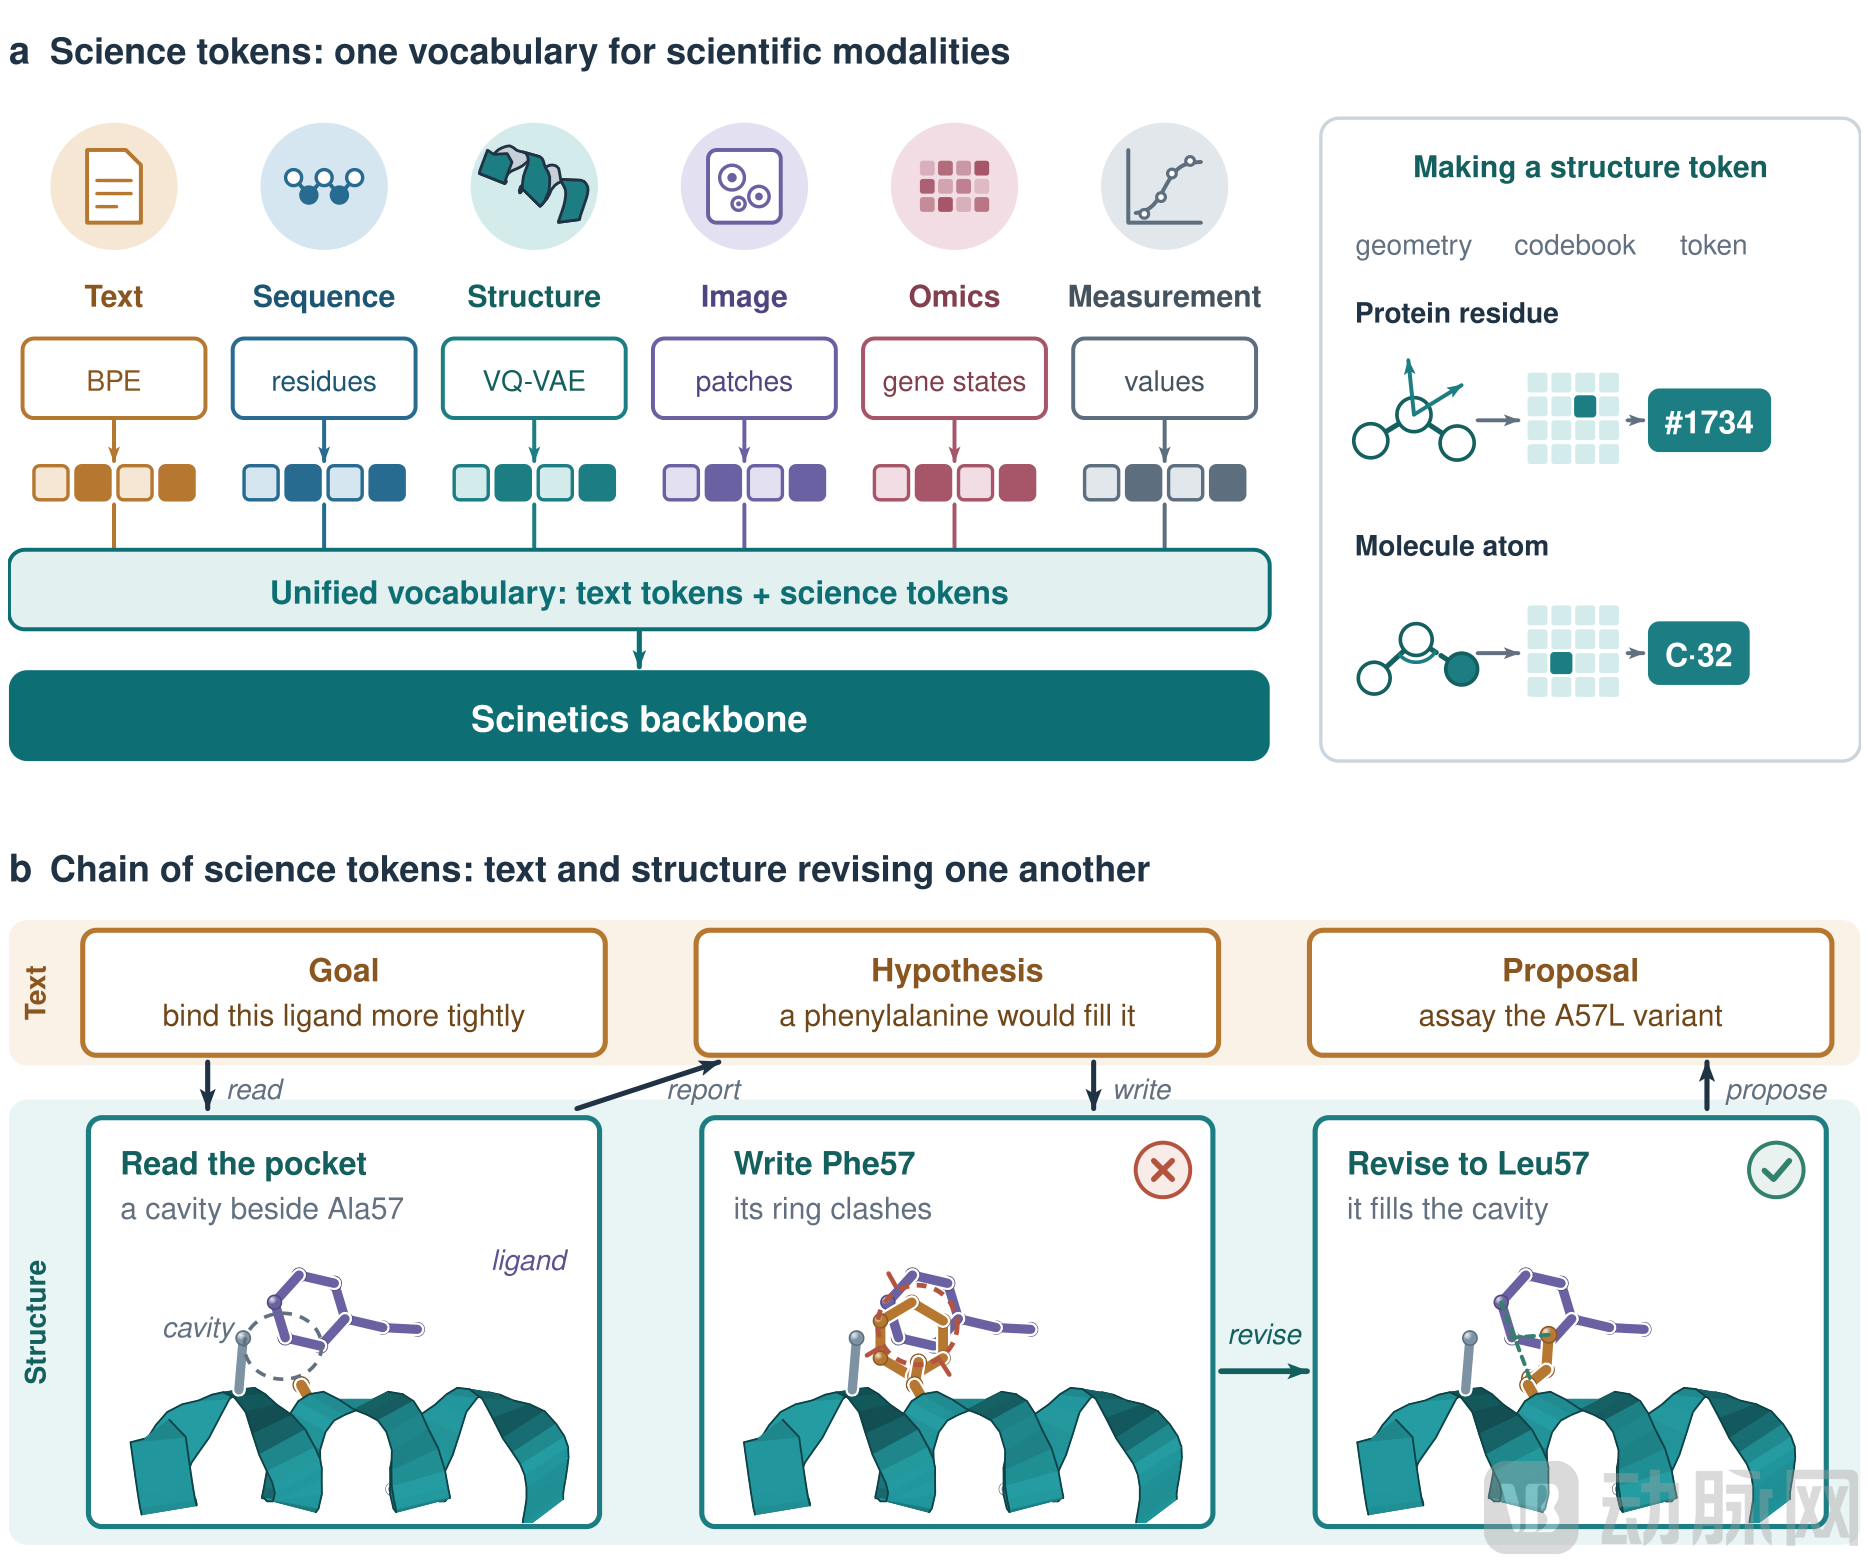
科学Token的多模态接口与结构推理概念示例(图源科理新序)
其Perspective还特别叮嘱一句专业细节:这些表示要“保留科学含义”——一个数值必须带单位、一次测量必须带条件、一个结构必须说明它来自预测还是实验。
配套的Chain of Science Tokens(科学Token链),则可以理解为思维链在科学世界里的对应物。传统思维链,每一步都是一个句子;科学Token链的中间步骤,则是一个个“能被解码的科学状态”。
科理新序 给出直观例子:模型先读一个蛋白口袋,试着塞进一个更大的侧链去填补空腔;几何一检查,发现它和配体撞上了,于是换成更合适的侧链,最后才提出实验建议。改变口袋几何,模型就该相应调整设计;可只是把同一个分子旋转一下,结论却应保持稳定。这样的可检验性,正是用来判断模型是不是真的用了科学信息。
“这不意味着要抛弃语言。语言是科学家提出问题、建立假设和沟通交流的重要方式。我们希望自然语言与科学原生表征深度融合,让模型在科学空间本身展开计算和推理。”Erik强调,“这与调用外部工具的智能体、串行拼接专家模型的流水线不同。后两者依靠接口传递信息,每转手一次就会丢失一层细节。”
这套理念最先在蛋白设计上落了地,具象成同期技术报告中的Chain of Structures(COS)——一项由MIT、哈佛、剑桥、港科大与科理新序共同完成的工作。
Chain of Structures技术报告标题与作者团队(图源科理新序)
有意思的是,团队没挑相对好做的折叠预测,而是挑了酶作为切入点——几个核心氨基酸位点的相对位置稍有扰动,催化活性就可能从有到无,这正是检验“化学意图能否落到局部几何”的硬骨头。在酶设计基准的对比中,COS六项指标拿下五项第一:三级酶分类一致率EC3达57.0%,高于CodeFP的55.3%;结构置信度pLDDT 79.3,结构自洽性TM-score 0.729。去掉推理链后,EC3降至53.4%,支持了中间推理步骤的作用。
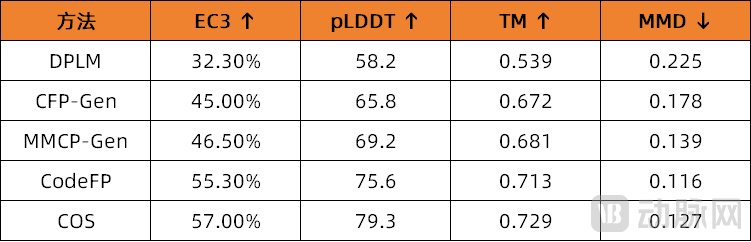
主结果节选(科理新序提供数据,动脉网制表)
“SOTA”限于报告所比较的方法与统一评测设置;完整六项指标见COS表3。
EC3为功能预测分类匹配,pLDDT为预测置信度,TM为结构自洽性,MMD衡量序列分布差异。
给科学智能立一把可验证的尺
有了概念,得先立一个目标。科理新序在Perspective里正式给出SSI(Scientific Super Intelligence,科学超级智能)的定义:同一个固定模型,既要在专业科学任务上胜过对应的垂直专家模型,又要在广泛的科学推理上,赢过同等参数规模的通用语言模型。
Scinetics Perspective:从Science Tokens到ScienceRSI(图源科理新序)
一句话,既要“专”,也要“通”。
“我们首先要做的,是一个通用的科学推理模型。”张载熙解释道,“既要在蛋白质结构预测、DNA突变预测、小核酸设计这些垂类任务上做得比以往更好,也要具备跨模态的科学推理能力——比如优化一套基因编辑系统,同时牵扯DNA、蛋白和功能文本多种模态,模型就得在同等体量下,比通用大模型更懂科学。”
报告给了一个值得检验的规模窗口:1000亿到3000亿参数,配合10万亿到30万亿训练Token。张载熙坦言,团队是基于在小模型上观察到的能力随参数、数据稳定提升的趋势进行外推,“大概率可以在这个量级达到SSI,但它仍是假设,不是结论”。
Perspective还补了一句关键提醒:训练Token要和独立证据分开算——同一份数据被反复喂给模型,只会增加计算量,并不会凭空多出新的实验事实;模型越大,真正稀缺的,反而越可能是高质量的科学反馈。
比目标更难的是路径。ScienceRSI,就是通往SSI的递归自我改进循环:当前代模型和智能体生成候选推理链,再交由模型之外的验证器,即模拟器、数据库、湿实验、领域专家——筛选打分,最后用幸存下来的证据去训练更强的下一代,如此循环放大。
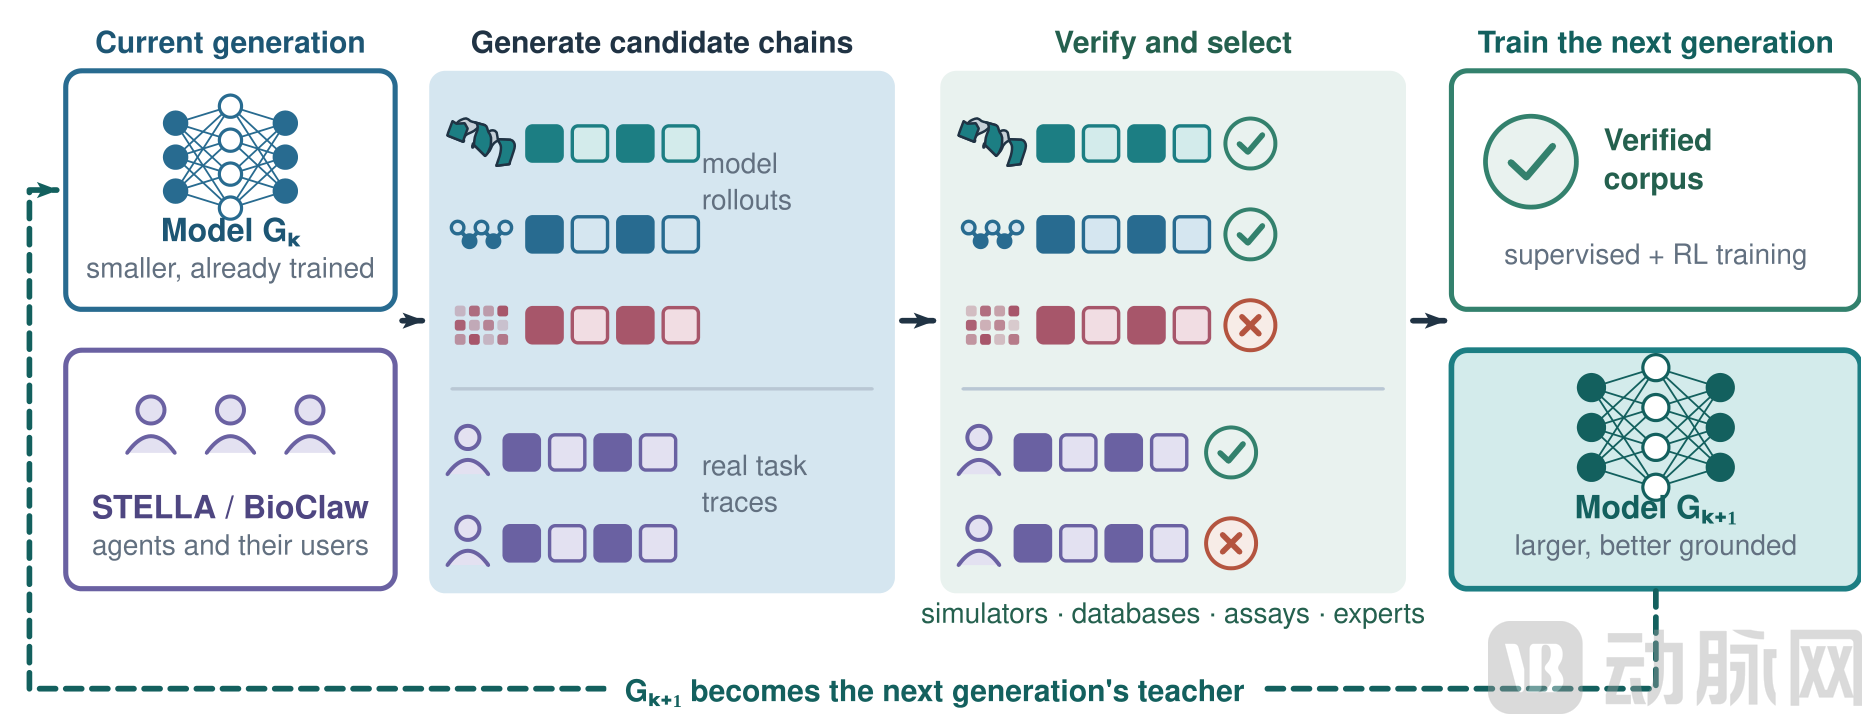
ScienceRSI研究设想:生成候选、外部验证、训练下一代模型(图源科理新序)
在这套循环里,失败同样值钱:一次结构冲突、一个无法复现的结果,都在告诉模型哪些路不值得再走。Perspective给这条路线定了三个硬指标:验证通过率、验证覆盖率、独立评测增益,只要有一个不涨,就该停下来。
值得一提的是,团队没有回避短板。COS报告标注,这些设计尚未经过湿实验验证,目前只是计算评测里的潜力展示,真实酶活性还得等湿实验检验。
把“预测、模拟、实测、独立复现”四级证据状态分开标注,恰恰是ScienceRSI对诚实二字的硬性要求。
大脑与手脚:为什么从第一天就不走单点工具路线
AI4S赛道里,多数公司都从单点工具切入:做分子筛选的只管筛选,做结构预测的只管结构,环节之间靠人传递。科理新序创立之初就明确了“AI4S基模×物理AI”双引擎:基模是负责认知的大脑,自动化实验室是负责执行的手脚,两者通过干湿闭环互相反馈。
布局双引擎的理由藏在“优化解的层级”里,Erik告诉动脉网,“很多AI算法本质是在找最优解、做梯度下降。单一模态下降到的所谓最优,往往是刻意把参数简化之后的局部最优——不考虑更多侧面和模态信息,找不到全局最优;科学是有泛化性的,把智能割裂在垂直盒子里,拼不出完整的科学发现能力。”
但双引擎,不等于两条线同时下重注。近一年,科理新序有意识地聚焦在基模的训练迭代上。物理AI这一侧,先以Agent的轻量形态落地,等模型能力到位,再自建自动化实验室把闭环合拢。
张载熙解释,团队过去在LabOS、STELLA这些学术工作里,既做过干侧模型,也做过硬件自动化和面向实验台的具身操作模型,知道闭环怎么搭,“只是选择先把大脑练强。在基模成熟之前,Agent被视为现阶段生命科学领域的较优解法、这是一个阶段性判断,不是终点。”
STELLA+LabOS自动化实验室(视频由科理新序提供)
科理新序介绍,他们的智能体已服务超过1000名科研用户,其中国际用户约七成来自斯坦福、普林斯顿等顶尖学府,国内覆盖国家重点实验室与高校,社群则聚集了1200多人、收到500多份共创申请。这些系统还曾在英伟达GTC大会和CES上亮相,并与美国上市的合成生物学公司Ginkgo Bioworks已经建立了合作。
更值得注意的是用户结构。早期用户里,有北大做育种与分子对接的团队,有协和血液科老师,也有南方一家牙医研究所——这些领域远离聚光灯,AI赋能程度低,连工具和数据都稀少。科理新序因此推出“共创者计划”,邀请各领域专家带来真实任务和稀缺数据,平台回赠使用额度,双方共建数据平台,目前已有近500位共创者参与,已经成长出一个比部分闭源库“更科学”的专业数据库。
Erik认为,“解决真实用户日常科研,临床,实验等不同任务,而不是让模型自己出题,恰恰能抑制逐代训练中多样性不断收窄的风险,而这正是ScienceRSI循环中最稀缺的一环。”
不按token收费:科学的价值密度与长期主义
由Science Token体系顺势延伸出的第四个概念,是整套框架里最具产业冲击力的Science-token economics(科学token经济学)。通用大模型习惯按输入输出的token数量计费,可这套逻辑在科研里不成立:一个300残基的酶设计,无论它吐出的是幻觉,还是真能用的催化剂,烧掉的token数几乎一模一样。
科理新序给这套经济学立了个出发点:两条长度一样的蛋白序列,消耗的输出token可能相同,科学价值却可以差到十万八千里:一条只是候选,另一条已经过实验测量、能在明确条件下完成目标反应。
于是科理新序干脆把账分成两本:模型token只用来计量训练和推理的计算成本;真正被拿来定价的,是一个个“科学资产”。那是版本化、可长期留存的数据包,里面装着科学对象本身、上下文(单位、条件、实验流程)、证据(测量结果与不确定性)以及来源(版本、验证记录、复用权限)。证据还分成预测、模拟、实测、独立复现四级,同样是一段序列,证据状态不同,价值天差地别。
落到商业化,目前,科理新序已与一些高校重点实验室、企业及实验室自动化厂商同步推进合作。但Erik判断,短期内智能体服务对科理新序的长期利润贡献较小,但真正的长期价值要落到公司产出的高价值科学发现——一个药物IP、一种生物材料,以产品模式去商业化。
行业冷热上,张载熙认为AI4S整体仍被低估:和世界模型、物理AI、具身智能相比,AI4S牵扯干湿闭环、周期更长、投入更大,估值却完全不在一个量级;在与美国同行的交流里,大家普遍把AI4S看成下一个“类似Copilot级别”的机会。
Erik则给了一个大胆的时间判断:“按我的理想,用不到3年,AI本身就能产出比领域专家更出色的科学发现。”他透露,团队期待明年暑假或下半年,模型能达到Perspective里描述的SSI规模与能力,届时涌现式能力和潜在商业化阐述都会丰富得多。团队招人也在同步扩张,欢迎大模型人才与医药研究工作者加入。
最后,张载熙用三个关键词给科理新序定了调:科学原生,模型从架构设计之初就兼容各类科学数据,为解决系统性科学问题而生;自进化,既沿模型体量、数据量向上生长,也通过ScienceRSI用小模型生产验证语料训练大模型;开放探索,AI for Science是通往AGI路上最重要的圣杯之一,面向科学探索,是人类最广阔、也最底层的一场革新。
回到波普尔的标准,这套体系的野心其实很清楚:把“可证伪”这件事机器化,让每个猜想都能走到能被检验的地方,让活下来的证据去训练下一代,让定价跟着证据而非字数走。通往科学通用智能的路不会一蹴而就,科理新序选择用长期主义穿越周期,把“可证伪”做成可持续的证据基础设施。

 渝公网安备 50011202502165号